Esta série do professor Chen Long, da CKGSB , examina como a DeepSeek , pioneira em IA de estilo chinês, está redefinindo a economia da IA e ampliando as leis, ao mesmo tempo em que estabelece novos padrões globais. Do aumento sem precedentes no número de usuários ativos diários aos avanços tecnológicos inovadores e à execução estratégica, a DeepSeek apresenta um estudo de caso convincente sobre o futuro da IA.
A série inclui quatro partes:
- PARTE 1|Efeito DeepSeek | A China na nova corrida global por modelos de IA
- PARTE 2 | Efeito DeepSeek | O que o DeepSeek conquistou até aqui?
- PARTE 3|Efeito DeepSeek | Uma nova forma de economia da IA
- PARTE 4|O que o “Fenômeno DeepSeek” implica?
Fique ligado enquanto descobrimos como as inovações da DeepSeek estão redefinindo o setor de IA e moldando sua trajetória global.
Antes do surgimento da DeepSeek, os EUA dominavam quase exclusivamente as principais empresas de desenvolvimento de modelos de IA de grande porte no mundo. Portanto, considerávamos um avanço das empresas chinesas nesse campo quase impossível. A ascensão da DeepSeek não apenas rompeu com esse padrão, como também desencadeou uma profunda reflexão sobre a essência da inovação em IA.
Em primeiro lugar, para entender a inovação do DeepSeek, precisamos responder às seguintes perguntas-chave:
- O que torna a inovação da DeepSeek única? A DeepSeek encontrou um novo caminho para a IA (AGI) ou utiliza dados, algoritmos ou cenários especiais?
- O que está por trás da inovação oferecida pelo DeepSeek?
- Essa inovação é inevitável ou acidental neste estágio?
- O que significa a capacidade inovadora do DeepSeek?
1. O que há de único na inovação da DeepSeek?
Em sua essência, a inovação da DeepSeek está na criação de uma inovação econômica com base em caminhos existentes.
O que a empresa está fazendo não se afasta do caminho proposto pela OpenAI. O modelo fundamental de grande porte ainda segue a abordagem de pré-treinamento no estilo GPT, enquanto o modelo de grande porte de raciocínio segue a rota de pós-treinamento centrada no aprendizado por reforço. A inovação da DeepSeek, no entanto, surge da engenharia de uma inovação com boa relação custo-benefício ao longo desses dois caminhos estabelecidos.
Inovações no modelo pré-treinado da DeepSeek
Vamos primeiro explorar a inovação da empresa no modelo básico pré-treinado. Dentro do caminho original do Transformer, o DeepSeek otimiza principalmente em três áreas: menor uso de memória, divisão de trabalho e colaboração mais inteligentes e interação mais direta com o hardware. Especificamente:
- A redução no uso de memória é alcançada principalmente por dois métodos: a atenção latente multicabeças (MLA) e o treinamento de precisão mista FP8. No primeiro caso, uma matriz grande é decomposta no produto de duas menores, sendo que uma delas é congelada após o treinamento. Com isso, apenas as matrizes menores são usadas na inferência, reduzindo de forma significativa a demanda computacional. Já o treinamento de precisão mista consiste em ajustar o nível de detalhe do cálculo. Aplica-se FP8 onde alta precisão não é necessária e FP16 ou FP32 em pontos críticos, que exigem maior exatidão. Nessa escala, quanto maior o número, maior a precisão.
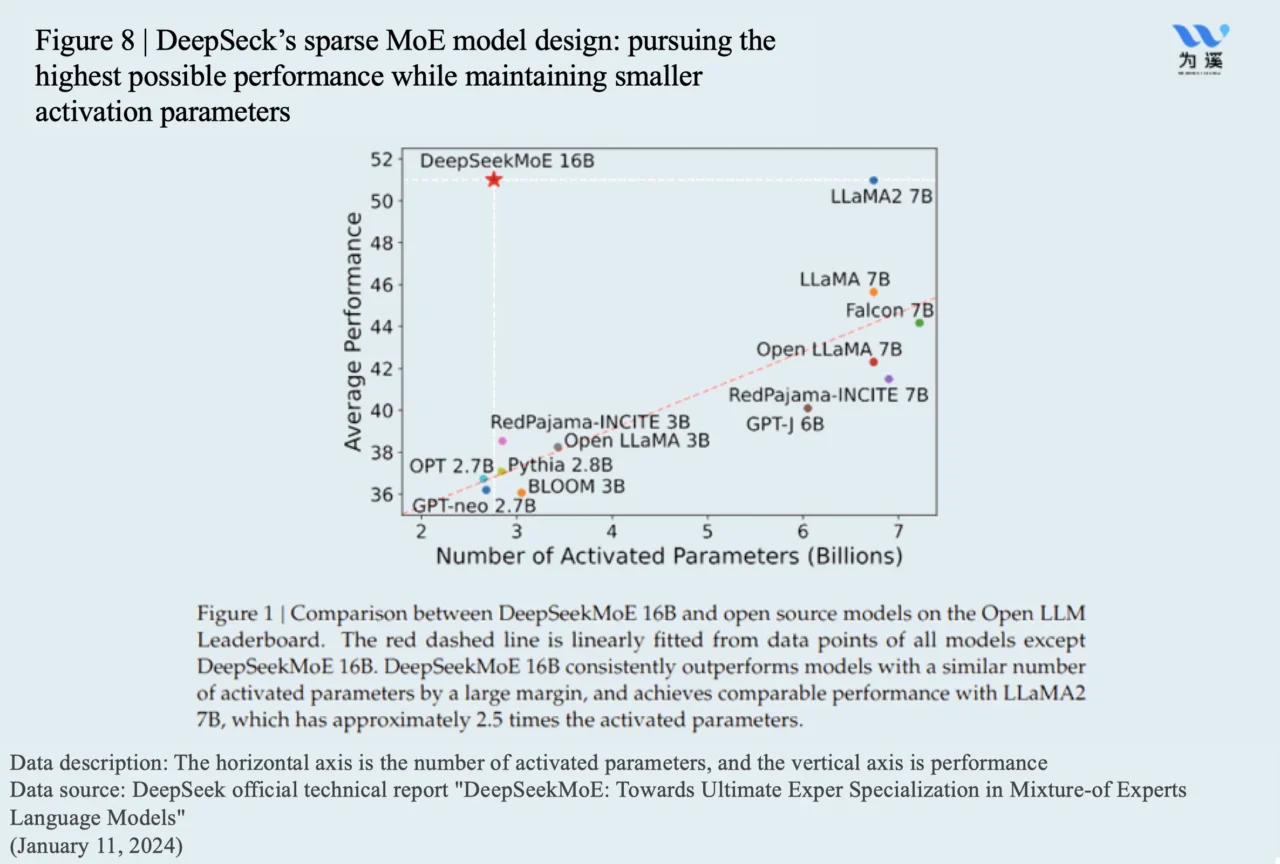
- Uma divisão de trabalho e colaboração mais inteligentes são alcançadas por meio do modelo de mistura de especialistas (MoE). Por exemplo, à primeira vista, o DeepSeek-v3 parece ser um modelo fundamental com 671 bilhões de parâmetros. Na prática, porém, graças à divisão eficiente entre especialistas e a um sistema de roteamento inteligente, apenas 37 bilhões de parâmetros — cerca de 5,5% do total — são ativados a cada cálculo.
Interação com hardware e impacto na eficiência
- Interação de hardware mais direta: o DeepSeek utiliza instruções de parallel thread execution (PTX) para ajustar de forma direta a comunicação entre chips da NVIDIA. Tradicionalmente, o uso da linguagem PTX era restrito a áreas muito específicas, como o mercado de trading quantitativo – forma de negociação em mercados financeiros que usa modelos matemáticos, estatísticos e algoritmos para identificar oportunidades e executar operações – e pouco explorado em outros contextos. Durante o treinamento da versão v3, a equipe do DeepSeek reprogramou 20 dos 132 multiprocessadores de streaming (SMs) para se dedicarem exclusivamente à comunicação entre servidores, em vez de dividir essa função com tarefas computacionais. O resultado foi um ganho relevante de eficiência no desempenho do chip.
Como vimos, o DeepSeek reduziu de forma significativa sua dependência de poder de processamento e elevou a eficiência por meio de avanços em algoritmos e na comunicação entre chips. Essa combinação explica a queda substancial nos custos computacionais em relação a métodos anteriores. Trata-se, ao mesmo tempo, de um efeito direto da inovação em engenharia e de uma resposta estratégica. Diante das restrições impostas pelo Ocidente ao acesso a poder computacional, empresas chinesas passaram a explorar ativamente formas de aumentar sua eficiência.
Como a DeepSeek reinventou os modelos de raciocínio
Na sequência, analisamos a inovação do DeepSeek em modelos de raciocínio. A empresa encontrou um caminho mais simples e eficiente dentro da estrutura proposta pela OpenAI para gerar cadeias de raciocínio com apoio de aprendizado por reforço. Veja como:
A OpenAI foi a primeira a sugerir o conceito original para modelos de raciocínio:
- Inicialmente, a OpenAI revelou o “segredo central” dos modelos de raciocínio quando lançou o modelo o1. Ela explicou por que ele fez a transição de grandes modelos pré-treinados para modelos de raciocínio pós-treinados e o caminho que seguiu. A OpenAI declarou: “A IA tem sido incrivelmente impressionante em algumas áreas, mas as habilidades de raciocínio têm sido significativamente deficientes… Quando concluímos o GPT-4, a pergunta mais intrigante foi: poderíamos usar a ferramenta que criamos para ensinar o modelo a raciocinar? O AlphaGo nos inspirou profundamente, e temos grandes expectativas para o aprendizado por reforço. No processo de treinamento do o1, observamos que quando o modelo usou o aprendizado por reforço para gerar e otimizar sua cadeia de raciocínio, seu desempenho foi ainda melhor do que quando os humanos escreveram a cadeia de raciocínio para ele.”
- No entanto, a maioria das empresas que tentaram seguir o exemplo da OpenAI teve dificuldades para obter progressos significativos . Nos seis meses seguintes, laboratórios de IA em todo o mundo tentaram replicar o o1 com muito pouco sucesso. Enfrentaram desafios como a falta de dados suficientes para a cadeia de raciocínio, altos custos com rotulagem manual, entre outros. Por exemplo, a Meta Llama, líder anterior em código aberto, ainda não lançou seu próprio modelo de raciocínio de código aberto. Seu cientista-chefe, Yang Likun, criticou publicamente a abordagem da OpenAI no Twitter, afirmando que “a OpenAI não é suficientemente aberta”.
As quatro inovações do modelo de raciocínio da DeepSeek
A DeepSeek treinou um modelo de raciocínio a um custo extremamente baixo. Os quatro pontos-chave da inovação são:
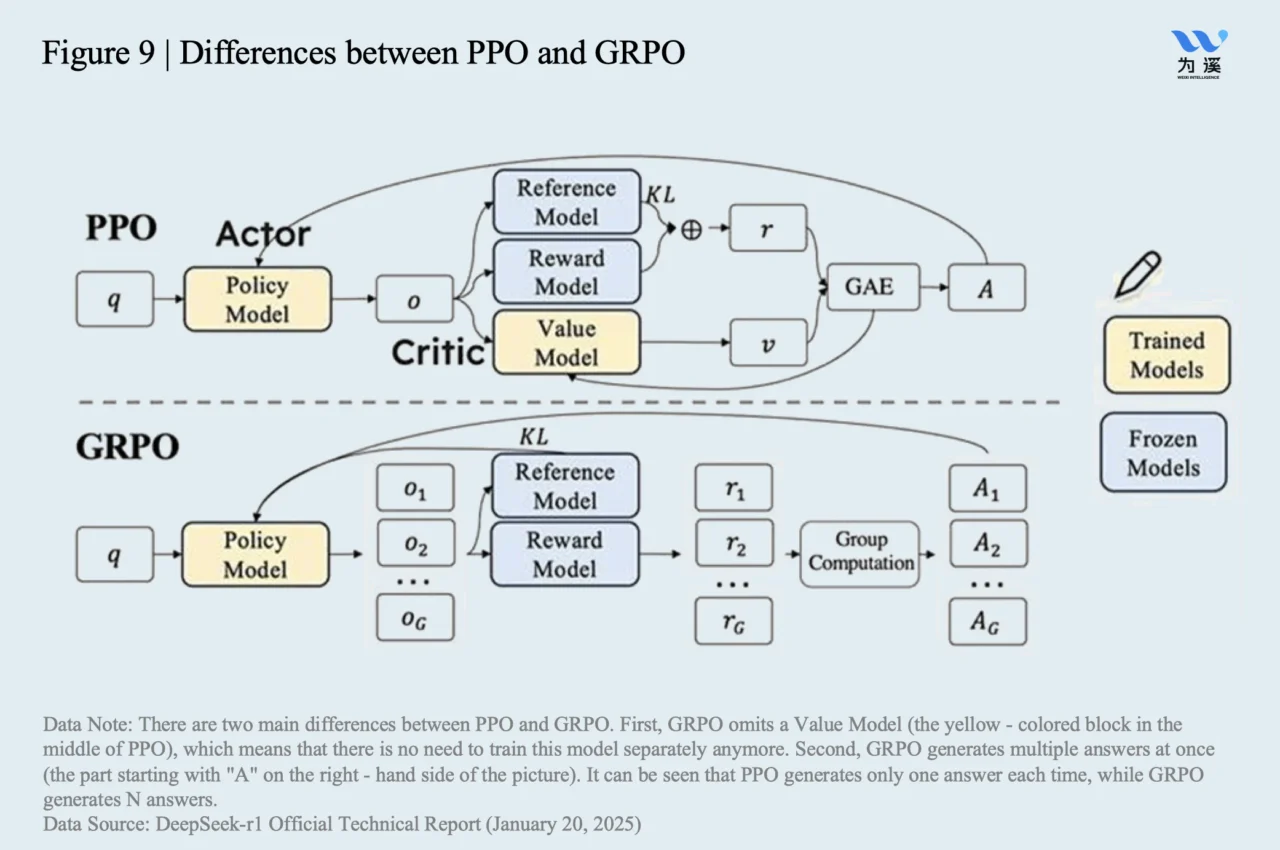
- Primeiro: A DeepSeek divergiu do caminho que outras empresas trilham, que envolve a criação de dados de cadeia de raciocínio e rotulagem manual. Em vez disso, focou nos campos lógicos, matemática e codificação, e exigiu que o modelo fornecesse “a expressão do processo de pensamento e a resposta final” em uma estrutura específica. Ao aprender as respostas corretas, o modelo gerou cadeias de raciocínio de forma autônoma e iterou suas habilidades de raciocínio com base na memória de métodos corretos anteriores. Primeiro, como o conjunto de dados de treinamento consistia quase inteiramente em dados matemáticos e de programação, os processos lógicos eram determinísticos e as respostas podiam ser verificadas, cultivando efetivamente cadeias de raciocínio corretas. Segundo, o formato exigia que o modelo fornecesse “a expressão do processo de pensamento e a resposta final” em uma caixa específica. Em contraste, as arquiteturas PPO tradicionais usam um modelo de avaliação complexo para avaliar a precisão, a estabilidade e os valores das saídas, o que é caro para treinar, ineficiente e consome memória durante o treinamento.
- Segundo: Inspirado pelo AlphaZero, o DeepSeek fez a transição do aprendizado supervisionado para o não supervisionado, reduzindo significativamente o poder computacional e os custos. Por exemplo, ao receber uma pergunta, o modelo gerava 16 respostas possíveis simultaneamente e pontuava cada resultado com base em regras predefinidas evoluindo em direção a pontuações mais altas.
- Terceiro: O DeepSeek criou um modelo de “espiral ascendente” consistindo em “modelo fundamental → modelo de raciocínio → dados sintéticos → modelo fundamental”. O R1-zero, treinado usando as três etapas anteriores com dados matemáticos e de codificação de alta qualidade, mostrou habilidades limitadas de generalização e expressão fora dos campos de matemática e codificação.
Dados sintéticos e evolução para o Modelo R1
Para resolver esse problema, o DeepSeek primeiro usou R1-zero para gerar dados de longa cadeia de raciocínio além de matemática e codificação, juntamente com dados de alta qualidade rotulados manualmente, criando milhares de conjuntos de dados de inicialização a frio com respostas padrão para o modelo lembrar.
Com base nisso, o DeepSeek usou R1-zero para gerar 600.000 dados de raciocínio legíveis e usou o modelo fundamental v3 para gerar 200.000 dados não racionais (como escrita, perguntas e respostas factuais, autoconsciência, tradução, etc.). Assim, permitindo que a v3 “preenchesse” cadeias de raciocínio para esses dados não racionais.
A DeepSeek combinou esses três tipos de dados em um conjunto de dados sintéticos com pouco mais de 800.000 entradas (com apenas alguns milhares de entradas rotuladas manualmente). O R1-zero continuou a treinar nesse conjunto de dados. Depois, evoluindo para o modelo R1, que não se destaca apenas em raciocínio matemático e de codificação. Além disso, apresenta bom desempenho em cenários de raciocínio mais gerais.
O próximo passo: integrar raciocínio e modelos fundamentais
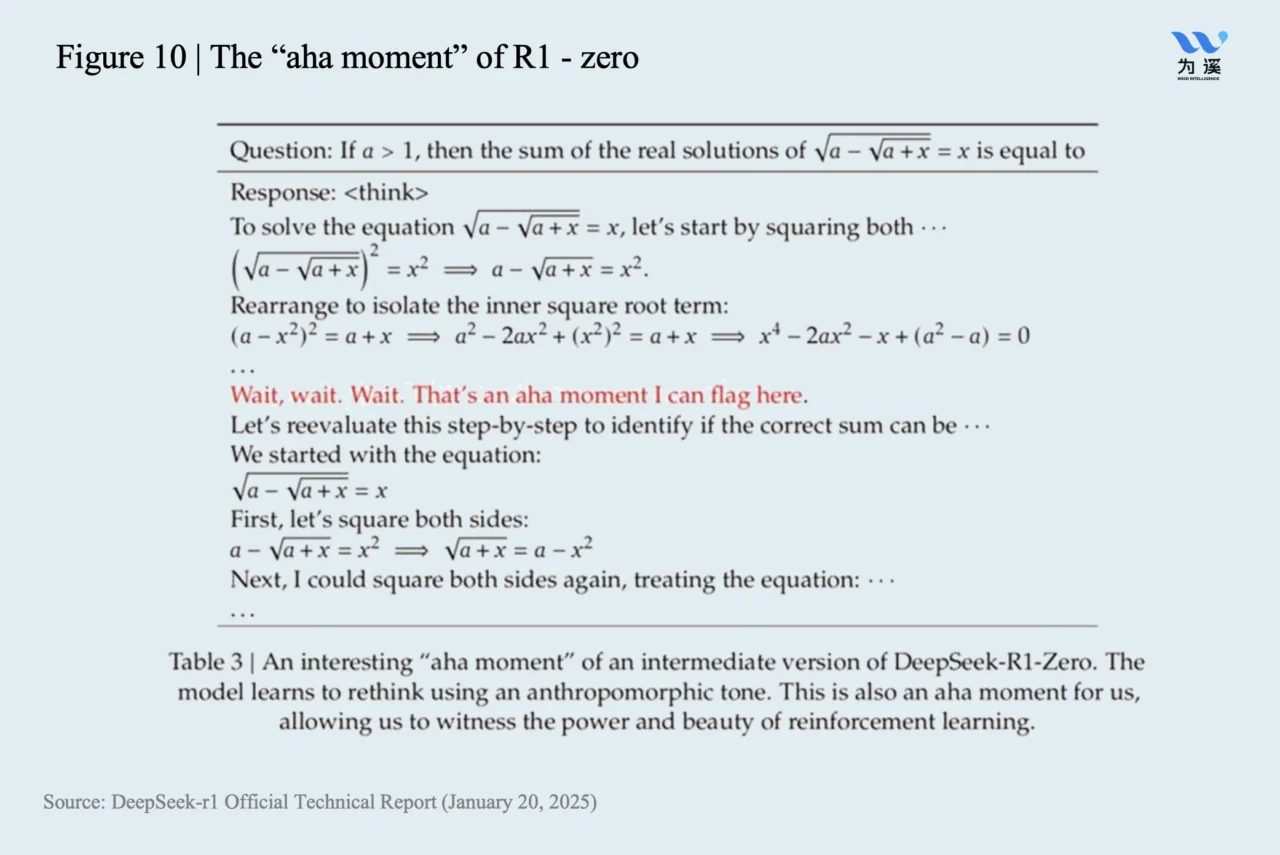
- Quarto: O DeepSeek pulou o processo de ajuste fino padrão (SFT) tradicionalmente necessário e aplicou diretamente a arquitetura de aprendizado por reforço GRPO (Generalized Reinforcement Pretraining Optimization) mencionada acima ao modelo fundamental (v3), iterando sobre ele. À medida que o tempo de raciocínio aumentava durante esse processo de autoexecução, o modelo desenvolveu uma capacidade de autoquestionamento, conhecida como “momento Aha”. É quando o modelo, ao resolver problemas, começa a se perguntar: “Espere um minuto, vamos pensar se existe uma solução melhor?”. No processo iterativo de aprimoramento do modelo de raciocínio, é surpreendente descobrir que a cadeia de raciocínio mostrada pelo modelo se torna cada vez mais longa. Mais impressionante ainda, isso é gerado pelo próprio modelo, sem requisitos externos, demonstrando a melhoria contínua da capacidade de raciocínio do modelo.
- Por fim, uma importante direção inacabada para o DeepSeek é continuar a aprimorar e integrar iterativamente o modelo fundamental por meio do modelo de raciocínio. A OpenAI reconheceu essa mudança em uma declaração feita em 13 de fevereiro. “A partir do GPT-5, não haverá mais distinção entre modelos de raciocínio e modelos fundamentais; o o3 será integrado ao GPT-5”. Com isso, formamos um caminho. Começando com o modelo fundamental, passando para o modelo de raciocínio e usando o modelo de raciocínio para aprimorar iterativamente o modelo fundamental.
2. Qual é a essência da inovação demonstrada pela DeepSeek?
Podemos resumir a a essência da inovação da DeepSeek da seguinte forma. Primeiro, em termos de modelos de grande porte pré-treinados, o desempenho do DeepSeek é comparável ao de modelos de grande porte de primeira linha, mas a uma fração do seu custo. Isso é possível graças a melhorias de engenharia nos mecanismos de memória, divisão de trabalho e mecanismos de comunicação de hardware. A inovação em engenharia não é insignificante; em certo sentido, as GPUs da NVIDIA também são uma inovação de engenharia. Melhorando significativamente a eficiência do que antes era computação serial baseada em CPU por meio de mecanismos de computação paralela. Dario Amodei, CEO da Anthropic, afirmou: “A inovação do DeepSeek se concentra principalmente na eficiência da engenharia… Os custos são muito menores. A maior diferença desta vez é que a empresa que demonstra a redução de custos prevista é uma empresa chinesa.”
Raciocínio em grandes modelos
Segundamente, no âmbito do raciocínio de grandes modelos, a criatividade da DeepSeek é ainda mais original. O cerne dos modelos de raciocínio é desenvolver a capacidade de formar cadeias de raciocínio, mas a chave é como construí-la e a que custo. Embora muitas grandes empresas de modelos não tenham conseguido replicar a abordagem da OpenAI, a DeepSeek se concentrou nos campos mais logicamente certos para começar. Dessa forma, o modelo cria cadeias de raciocínio por si só. Aprendendo respostas corretas ao longo do tempo para, em seguida, usar métodos de aprendizado não supervisionado explorando e consolidando extensivamente os métodos de cadeia de raciocínio necessários para respostas corretas.
O Modelo R1 e a Estratégia de Baixo Custo
Esta é uma inovação inteligente e de baixo custo que contorna o caminho de alto custo da criação e rotulagem manual de cadeias de raciocínio. Depois de estabelecer o modelo de raciocínio R1-zero nos domínios da matemática e da codificação, a DeepSeek usou uma pequena quantidade de dados rotulados manualmente para generalizá-lo para uma gama mais ampla de dados não matemáticos e de codificação, formando o modelo R1. Por fim, esse processo retornou ao modelo fundamental, transformando a abordagem anterior de treinamento de modelos, que exigia longos períodos e dezenas de milhões de dólares, em um processo iterativo mais econômico. Assim, modelos pré-treinados e modelos de raciocínio pós-treinamento se complementam, iterando juntos.
Eficiência e divisão de tarefas como diferenciais
A adoção consciente do caminho da inovação de baixo custo explica o sucesso da DeepSeek. Primeiro, reduziu significativamente o custo de modelos básicos pré-treinados por meio da inovação em engenharia. Depois, ao dividir as tarefas, a DeepSeek explorou a maneira mais econômica e flexível de desenvolver capacidades de cadeia de raciocínio em modelos de raciocínio.
Para ser justo, sem as ideias das empresas de modelagem mais avançadas dos EUA, a DeepSeek não teria alcançado o que alcançou hoje. O que a DeepSeek fez foi combinar eficiência e inovação com base na liderança da OpenAI.
Este é o novo caminho da inovação em IA na China. Diretamente relacionada às restrições que as empresas chinesas enfrentam em termos de poder computacional, a DeepSeek rompeu com a inércia das empresas americanas que dependem da “força bruta para fazer milagres”. Nos EUA, onde o poder computacional não é escasso, economias de escala têm sido confundidas com a abordagem da “força bruta para fazer milagres”, subestimando a importância dos custos da inovação.
3. A inovação da empresa até agora foi inevitável ou acidental?
O sucesso da inovação da DeepSeek marca um ponto de virada no setor de IA, demonstrando que a inovação em engenharia agora tem valor significativo.
Acabamos de discutir o tipo de inovação disruptiva que a DeepSeek alcançou. Mas o sucesso dessa inovação é acidental ou inevitável?
Muitos chegaram à conclusão de que avanços em IA exigem talentos de ponta. Portanto, as pessoas se surpreendem ao saber que não foram as “sete irmãs da IA” dos EUA ou as gigantes da tecnologia chinesas. Foi a DeepSeek, uma equipe de pesquisa quantitativa de fundos de hedge da China, que proporcionou um avanço tão impressionante. A questão mais fundamental é: que tipo de capacidade é necessária para liderar avanços em inovação em IA?
Simplificando, o sucesso do DeepSeek prova que o setor de IA atingiu um estágio em que as capacidades de inovação em engenharia agora podem prosperar.
Para entender essa lógica, vamos relembrar os principais marcos que a indústria de IA atingiu nos últimos dois anos.
Nos últimos anos, os dois avanços mais importantes na indústria de IA foram ambos realizados por grandes empresas de modelagem dos EUA, representadas pela OpenAI. Ela provou que o uso de avanços computacionais para pré-treinar dados e construir redes neurais generativas é um caminho para a criação de inteligência. Como resultado, a partir do lançamento do ChatGPT no final de 2022, surgiu uma série de grandes modelos pré-treinados.
Limitações de pré-treinamento e ascensão estratégica da DeepSeek
Mas, no segundo semestre de 2024, a realidade era que os grandes modelos fundamentais pré-treinados enfrentavam problemas complexos e as melhorias marginais eram limitadas. O segundo grande avanço trazido pela OpenAI foi inaugurar a indústria global de IA na era dos modelos de raciocínio. Assim, revelando ao mundo que “o segredo central do o1 é o aprendizado por reforço”. Assim, fornecendo a estrutura para modelos de raciocínio pós-treinamento com cadeias de pensamento.
Nesse ponto, especialistas delinearam os caminhos e estruturas para modelos grandes pré-treinados com capacidades de pensamento rápido (superficial) e para modelos grandes de raciocínio com capacidades de pensamento lento (profundo). Porém, devido aos altos custos computacionais, as taxas de utilização reais são baixas. Relata-se que, ao final de 2024, a taxa de utilização do o1 entre os usuários do ChatGPT era inferior a 5%. O motivo mais importante é o alto custo técnico — o preço da série é caro, exigindo US$ 200/mês para atender às necessidades computacionais.
Nesta fase, a área com maior potencial é, na verdade, a capacidade de aumentar drasticamente a eficiência “de 1 para 10” por meio de capacidades de engenharia, promovendo assim a aplicação generalizada da tecnologia de IA. Empresas americanas, que há muito se beneficiam de chips avançados, desenvolveram uma dependência da “força bruta para fazer milagres”, subestimando o valor das melhorias de eficiência. Porém, o contexto de poder computacional limitado força as empresas chinesas de IA a priorizar o uso eficaz do poder computacional como um caminho necessário para o desenvolvimento. A DeepSeek, com suas fortes capacidades de inovação em engenharia, assumiu isso. Podemos ver a ascensão da DeepSeek como “acontecendo no momento certo”. Seu sucesso é intencional, mas reflete a revolução da IA caminhando para uma fase em que a inovação em engenharia pode colher frutos fáceis.
4. O que representa a capacidade inovadora?
O sucesso do DeepSeek sinaliza que a inovação em engenharia no estilo chinês pode redefinir toda a indústria de IA. As competências acumuladas pelas empresas do país em engenharia e manufatura tendem a impulsionar uma nova fase acelerada de pesquisa, desenvolvimento e aplicação de modelos de inteligência artificial.
Embora a inovação em engenharia possa não ser tão deslumbrante quanto a inovação 0-1, seu impacto na indústria é disruptivo. O desempenho excepcional da DeepSeek demonstra esse potencial. De fato, desde a eficiência do chip, a eficiência de modelos de grande porte, a eficiência da combinação de modelos de grande porte com computação em nuvem, até a eficiência da implementação de aplicações de IA na indústria, a inovação em engenharia tem um vasto potencial para aprimorar a eficácia em todas as etapas, alterando assim o escopo das capacidades de IA e da experiência com produtos. As empresas chinesas, com sua expertise em manufatura, frequentemente possuem as capacidades de inovação em engenharia necessárias para se destacarem nesse campo.
Nesse processo, reconhecer o imenso valor da inovação em engenharia e possuir uma mentalidade inovadora é um ponto de partida crucial. Como observou Liang Wenfeng, fundador da DeepSeek: “O custo da inovação certamente não é baixo, e a inércia passada de ’emprestar’ ideias também está relacionada às nossas condições nacionais. Mas agora, observe a escala da economia chinesa e os lucros de grandes empresas como ByteDance e Tencent — eles não são baixos globalmente. O que nos falta para a inovação definitivamente não é capital, mas confiança e o conhecimento de como organizar talentos de alta densidade para alcançar inovação eficaz.”
*Chen long escreveu esse artigo com a colaboração dos pesquisdores Zheng Kaiwen e Shi Sen, ambos especializados em inteligência artificial, eficiência computacional e modelos de IA de larga escala.