N.E. Esta série do professor Chen Long, da CKGSB, examina como a DeepSeek, pioneira em IA de estilo chinês, está redefinindo a economia da inteligência artificial.
Além disso, analisa como a empresa amplia fronteiras legais e estabelece novos padrões globais. Do aumento sem precedentes no número de usuários ativos diários aos avanços tecnológicos.
a DeepSeek oferece um estudo de caso convincente sobre o futuro da IA. A série inclui quatro partes principais: leia aqui.
Fique ligado enquanto descobrimos como as inovações da DeepSeek estão redefinindo o setor de IA e moldando sua trajetória global.
Para entender plenamente o impacto do DeepSeek na indústria de IA, é necessário antes compará-lo aos principais modelos de grande porte do mundo. Esses modelos se dividem em duas categorias: os fundamentais, pré-treinados, e os de inferência, desenvolvidos após o treinamento. De modo geral, o DeepSeek já alcançou o patamar dos principais modelos norte-americanos em ambas as frentes.
01|Uma comparação de grandes modelos de IA na China e nos Estados Unidos
Vamos começar comparando grandes modelos fundamentais pré-treinados com base em dados textuais. O produto relevante da DeepSeek é o DeepSeek-v3.
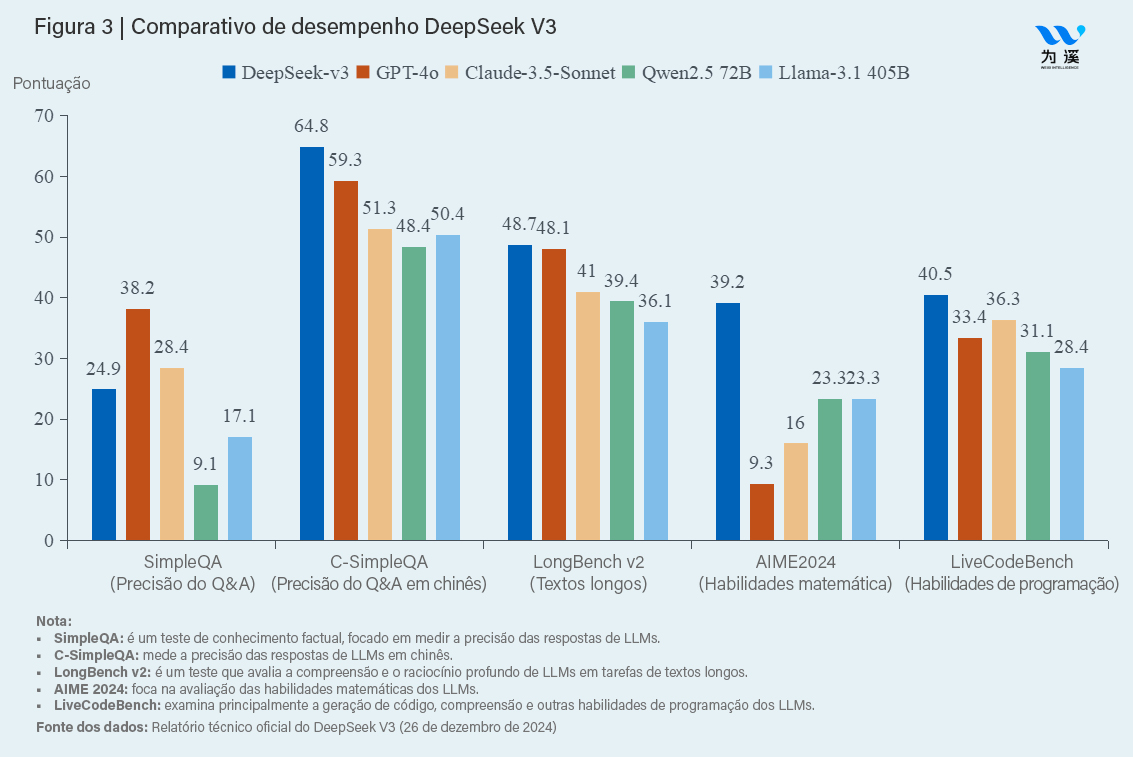
Conforme mostrado na Figura 3, o DeepSeek-v3 supera os dois principais modelos grandes dos EUA: o GPT-4o, da OpenAI, e o Claude-3.5-Sonnet, da Anthropic.
Ele se destaca em quatro dimensões: precisão em perguntas em chinês, processamento de textos longos, habilidade matemática e capacidade de codificação.
A única área em que fica atrás é na precisão de resposta a perguntas sobre conhecimento factual. Ao mesmo tempo, como um produto de código aberto, o DeepSeek-v3 supera outros modelos grandes de código aberto.
Ele super gigantes como o Qwen 2.5 72B da Alibaba e o Llama-3.1 405B da Meta, em todas essas dimensões.
A comparação dos modelos
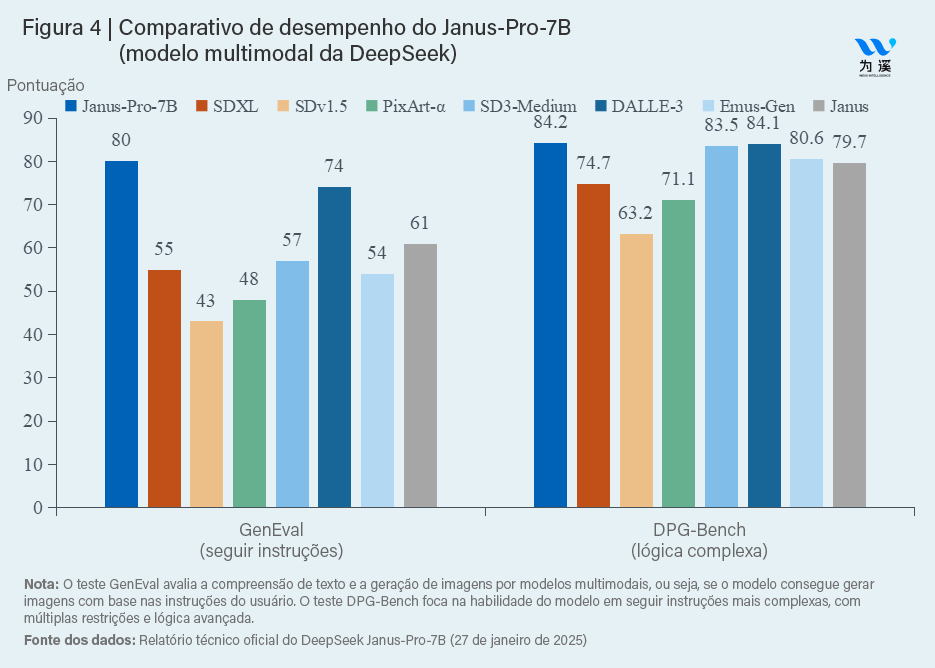
A seguir, vamos comparar modelos multimodais de grande porte pré-treinados. O modelo multimodal da DeepSeek é o Janus-Pro-7B.
Conforme mostrado na Figura 4, no teste GenEval, que avalia a capacidade desse modelo de seguir instruções. Ou seja, se ele consegue entender com precisão entradas complexas do usuário e gerar imagens que atendam aos requisitos. O Janus-Pro-7B superou os principais modelos de grande porte comparáveis, incluindo o DALL-E 3 e o Stable Diffusion.
Da mesma forma, no teste DPG-Bench — que mede a habilidade de um modelo em lidar com lógica complexa, isto é, processar prompts de texto com múltiplas restrições e atender às condições exigidas — o Janus-Pro-7B também se destacou, superando seus concorrentes.
Até aqui, comparamos grandes modelos fundamentais pré-treinados, baseados em texto e dados multimodais. Esses modelos — como o GPT-4 — são mais eficazes para resolver problemas que não exigem raciocínio profundo. Para lidar com questões mais complexas, no entanto, é preciso recorrer a modelos de inferência. Esses modelos são capazes de decompor os problemas em cadeias de raciocínio estruturadas e realizar pensamento profundo a partir do modelo pré-treinado.
O lançamento do GPT-4
Após o lançamento do GPT-4, a OpenAI reconheceu que o avanço da IA dependia desse tipo de raciocínio mais elaborado e, em 2024, apresentou o modelo de inferência pós-treinamento OpenAI-o1.
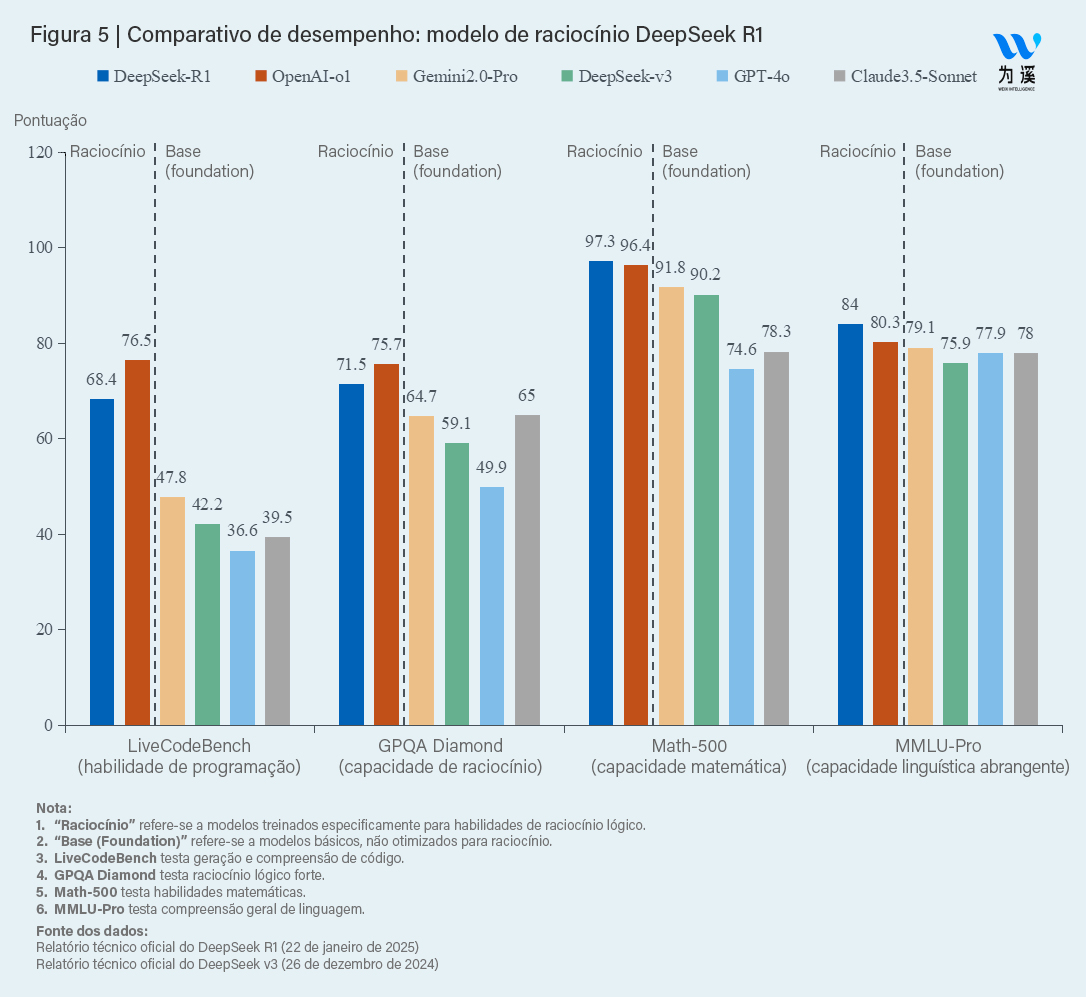
No caso do DeepSeek, o equivalente é o DeepSeek-R1, hoje seu modelo de inferência mais utilizado. Como mostra a Figura 5, tanto o OpenAI-o1 quanto o DeepSeek-R1 apresentam desempenho superior a diversos modelos fundamentais. A superioridade aparece em áreas como codificação, raciocínio, matemática e linguagem geral — evidenciando os ganhos proporcionados pelo pensamento profundo.
Na comparação direta, o DeepSeek-R1 fica atrás do OpenAI-o1 em capacidade de codificação e raciocínio, mas o supera em matemática e linguagem. No geral, os dois modelos apresentam níveis de desempenho considerados próximos.
A DeepSeek não é a única empresa chinesa a alcançar os principais modelos americanos. Tanto a The Economist, de 25 de janeiro de 2025, quanto o ex-CEO do Google, Eric Schmidt, em seus comentários recentes, mencionaram dois grandes modelos chineses: DeepSeek e Qwen. O mais recente modelo básico pré-treinado da Alibaba, Qwen2.5-Max, foi lançado em 29 de janeiro de 2025. Conforme mostrado na Figura 6, na avaliação mais recente, o Qwen2.5-Max superou o modelo básico pré-treinado da DeepSeek, DeepSeek v3. Em várias avaliações, superou a capacidade matemática, raciocínio, poder de codificação e desempenho geral.
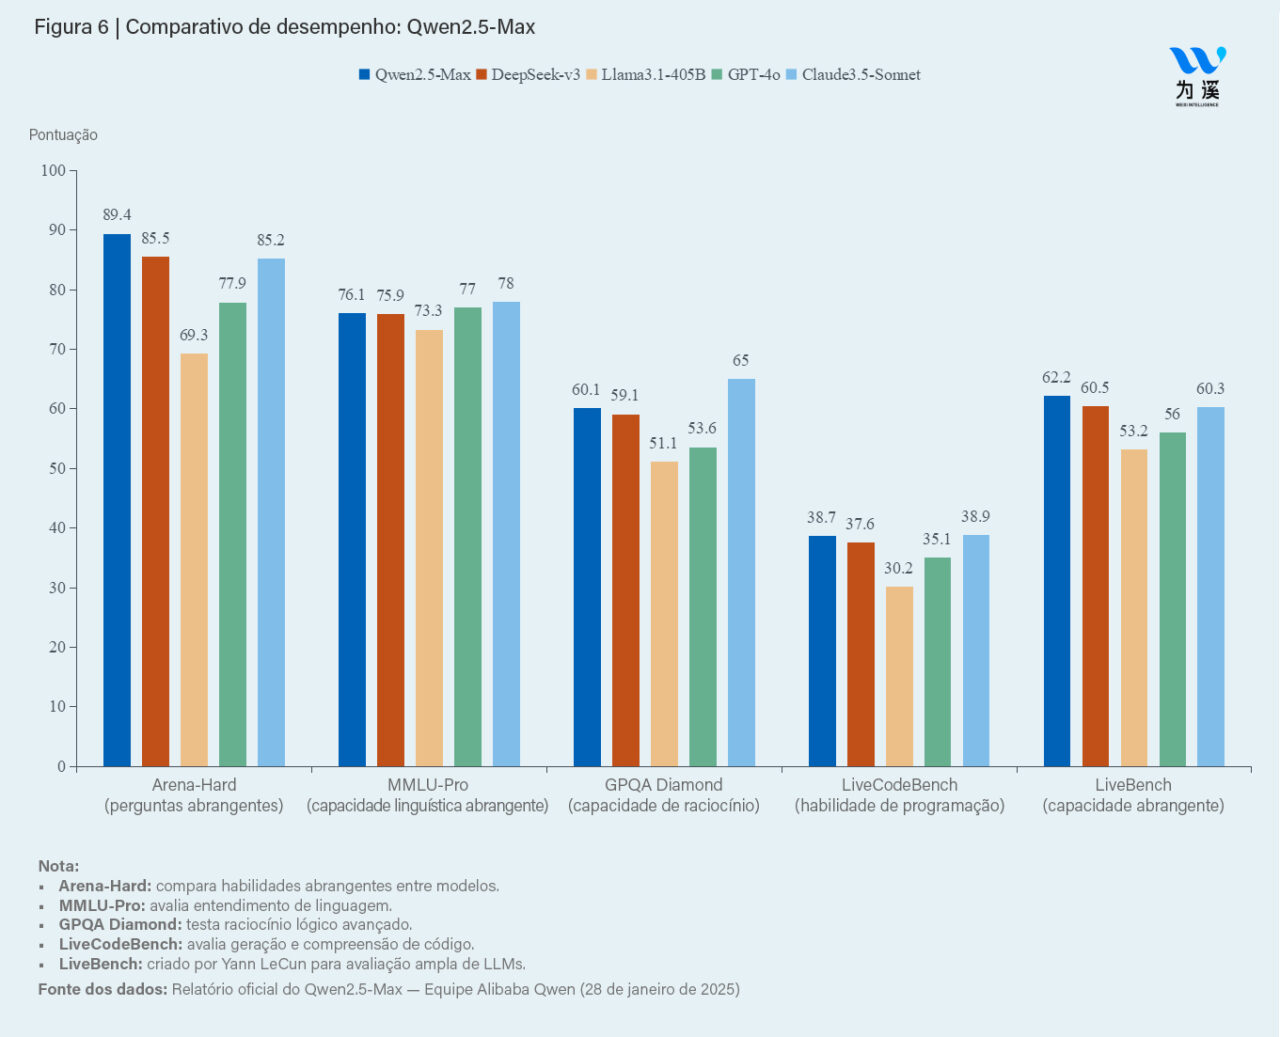
Em resumo, podemos tirar uma conclusão inovadora: as novas forças chinesas da IA, representadas por empresas como DeepSeek e Alibaba (com seu modelo Qwen), efetivamente alcançaram os modelos americanos de grande porte mais avançados nas áreas de modelos fundamentais pré-treinados e modelos de raciocínio pós-treinados. Isso indica que a lacuna entre os modelos americanos e chineses de grande porte não está aumentando, mas sim diminuindo.
02 | “Fenômeno DeepSeek” – A vantagem da eficiência de custo
Embora os grandes modelos chineses tenham alcançado seus equivalentes americanos, o que é ainda mais impressionante é sua vantagem em termos de custo-benefício.
Em janeiro de 2025, no Fórum Econômico Mundial em Davos, o CEO da Microsoft, Satya Nadella, declarou abertamente:
“O desempenho dos novos modelos do DeepSeek é impressionante, especialmente em termos de eficiência de inferência de modelos. Devemos levar a sério esses desenvolvimentos da China.”
Como Nadella destacou, o verdadeiro avanço em custo feito pelos grandes modelos chineses é o que é verdadeiramente notável. De acordo com a DeepSeek, o custo de treinamento de seu modelo pré-treinado, DeepSeek-v3, é de cerca de US$ 5,58 milhões. Esse valor reflete o custo computacional durante o treinamento oficial. Ou seja, horas de GPU usadas durante o treinamento oficial × preço de aluguel do H800 por hora de GPU × 55 dias. Por outro lado, esse cálculo não inclui os custos de arquitetura inicial, pesquisa de algoritmos e custos de tentativa e erro de experimentos de ablação. Em comparação, o treinamento da Meta do Llama 3.1 405B custou cerca de US$ 58 milhões (usando mais de 16.000 GPUs NVIDIA H100 em 54 dias).
8.000 GPUs NVIDIA H100
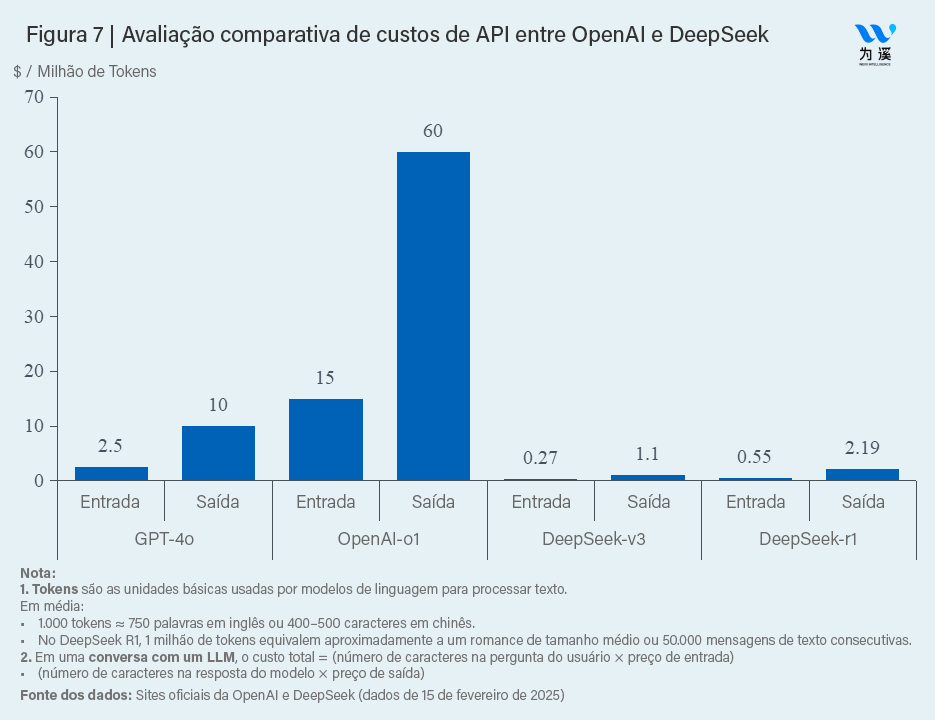
Enquanto isso, Jensen Huang, CEO da NVIDIA, mencionou no GTC 2024 que treinar um modelo GPT com 1,8 trilhão de parâmetros exigiria cerca de 8.000 GPUs NVIDIA H100 em 90 dias. O cálculo estima o custo de treinamento do GPT-4 em cerca de US$ 48 milhões. Além disso, Arthur Mensch, fundador da Mistral AI, revelou que o custo de treinamento do Mistral Large foi inferior a US$ 22 milhões, e Dario Amodei, CEO da Anthropic, revelou que o custo de treinamento do Claude 3.5 Sonnet foi de dezenas de milhões de dólares. Em comparação, o custo de pré-treinamento do DeepSeek-v3 é cerca de 1/10 do dos principais modelos europeus e americanos. Em consonância com isso, como mostrado na Figura 7, o preço da chamada de API para o DeepSeek-v3 é cerca de 10% do do GPT-4.
Agora, vamos examinar os custos de treinamento e uso dos modelos de raciocínio. O DeepSeek-R1 é treinado com base no modelo pré-treinado DeepSeek-V3. Como explicaremos mais adiante, seja usando o método do DeepSeek para criar um modelo de raciocínio ou destilando um modelo menor, os custos de treinamento são extremamente baixos. Por exemplo, o modelo destilado pela equipe de Fei-Fei Li, S1, custou apenas US$ 50, sendo apelidado com humor de “modelo de raciocínio em xícara de café”.
O custo de inovação
Em termos de uso, como mostrado na Figura 7, curiosamente, o modelo de inferência do OpenAI (OpenAI-o1) tem um custo de invocação 6 vezes maior que o de seu modelo pré-treinado (GPT-4o). Enquanto isso, o custo de invocação do DeepSeek-R1 é apenas o dobro do DeepSeek-v3. Isso significa que o aumento no custo de uso dos modelos de raciocínio do DeepSeek é muito mais lento que o do GPT, resultando no custo de invocação do DeepSeek-R1 sendo inferior a 5% do OpenAI-o1.
Disto, podemos tirar uma segunda conclusão inovadora: as empresas chinesas atingiram um nível de eficiência de custos tal que os custos relacionados aos seus modelos são inferiores a 10% daqueles dos grandes modelos americanos de primeira linha.
A combinação de modelos de ponta de grande porte e custos significativamente mais baixos representa o avanço mais importante demonstrado pela DeepSeek, marcando a entrada da indústria de IA em uma nova fase de crescimento e economias de escala. Do ponto de vista do cenário industrial, esse avanço é disruptivo.
* Chen long escreveu esse artigo com a colaboração dos pesquisdores Zheng Kaiwen e Shi Sen, ambos especializados em inteligência artificial, eficiência computacional e modelos de IA de larga escala.